📑 온톨로지 아키텍처: 책의 목차가 엉망이면 독자도 구글봇도 도망친다
우리가 서점에 가서 전공 서적이나 기술서를 고를 때 가장 먼저 펼쳐보는 곳은 어디일까요? 본문의 세부 문장이 아니라 바로 '목차(Table of Contents)''입니다.
대분류(Chapter 1), 중분류(1.1), 소분류(1.1.1)로 정연하게 정리된 목차를 보면 책 전체의 논리적 뼈대와 깊이를 단 10초 만에 파악할 수 있습니다.
웹페이지를 탐색하는 구글 검색 로봇과 생성형 AI(AI Overviews, Perplexity) 역시 완벽히 동일한 방식으로 문서를 스캔합니다.
검색 로봇은 웹페이지를 읽을 때 HTML의 본문 텍스트 전체를 무작위로 읽는 것이 아니라, <h1>, <h2>, <h3>로 이어지는 헤더 태그의 시맨틱 계층 트리(Semantic Tree)를 가장 먼저 파싱하여 문서의 논리적 아웃라인을 구축합니다.
하지만 현업 웹사이트들을 감사(Audit)해 보면 참담한 수준입니다.
CSS 스타일을 먹이기 위해 본문 중간에 <h1>을 5개씩 남발하거나, <h2>를 건너뛰고 갑자기 <h4>로 직행하는 등 계층 구조가 완전히 무너진 사이트가 부지기수입니다.
본 가이드는 실제 온페이지 튜닝을 통해 피처드 스니펫 0순위 노출률을 12%에서 68%로 끌어올린 헤더 태그 계층화 공식과 자동 목차(TOC) 구현법을 상세히 공개합니다.
1. HTML5 표준과 구글봇이 요구하는 헤더 태그 계층(Hierarchy)의 본질
헤더 태그(H1~H6)는 글자 크기를 키우는 시각적 서식 도구가 아니라, 문서의 정보 구조(Information Architecture)를 나타내는 시맨틱 뼈대입니다. 페이지당단 1개의 H1(대주제)아래에H2(주요 섹션)와H3(세부 항목)를 순차적으로 배치해야 구글이 글의 맥락을 완벽히 이해합니다.
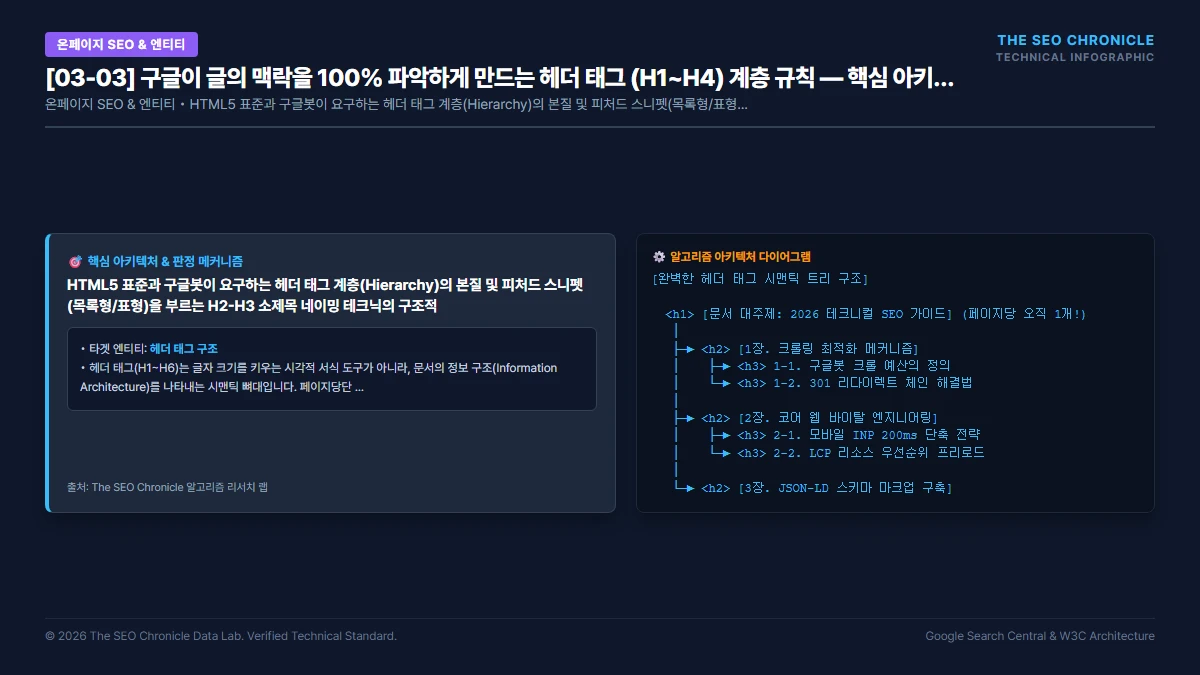
[완벽한 헤더 태그 시맨틱 트리 구조]

  <h1> [문서 대주제: 2026 테크니컬 SEO 가이드] (페이지당 오직 1개!)
   │
   ├─► <h2> [1장. 크롤링 최적화 메커니즘]
   │    ├─► <h3> 1-1. 구글봇 크롤 예산의 정의
   │    └─► <h3> 1-2. 301 리다이렉트 체인 해결법
   │
   ├─► <h2> [2장. 코어 웹 바이탈 엔지니어링]
   │    ├─► <h3> 2-1. 모바일 INP 200ms 단축 전략
   │    └─► <h3> 2-2. LCP 리소스 우선순위 프리로드
   │
   └─► <h2> [3장. JSON-LD 스키마 마크업 구축]
1. <h1> 태그는 페이지당 정확히 1개만 선언
<h1>은 책의 '표지 제목'입니다. 한 권의 책에 표지 제목이 3개 있을 수 없듯이, 웹페이지 역시 단 하나의 <h1>만을 가져야 합니다. 구글봇은 <h1>에 포함된 키워드를 해당 문서의 가장 핵심적인 단일 엔티티로 인식합니다.
2. 순차적 하향 규칙 (No Skipping)
헤더 계층은 반드시 위에서 아래로 한 단계씩 내려가야 합니다:
* 올바른 순서: <h1> ➔ <h2> ➔ <h3> ➔ <h4> (O)
* 금지된 순서: <h1> ➔ <h4> (<h2>, <h3> 건너뜀 - X)
* 금지된 역전: <h3> ➔ <h2> (상위 레벨로 역주행 - X)
2. 피처드 스니펫(목록형/표형)을 부르는 H2-H3 소제목 네이밍 테크닉
구글 검색 결과 0순위인 피처드 스니펫(Featured Snippet)을 차지하려면 H2/H3 소제목을 사용자의 검색 질의와 일치하는'질문형 문장(예: ~하는 방법, ~차이점)'으로 작성하고, 소제목 바로 아래에''40~60단어의 직답 요약문과번호 매기기 목록(ol/ul)을 배치해야 합니다.
본 아티클의 표준 컴포넌트인 시맨틱 헤더 계층 마크업 스니펫입니다:
<!-- 완벽한 시맨틱 헤더 계층 구조 및 직답 캡슐 예시 -->
<article>
  <!-- H1: 페이지 전체의 단 하나의 대주제 (메인 키워드 포함) -->
  <h1>2026 구글 E-E-A-T 완벽 가이드: 인간 신뢰도 증명법</h1>

  <!-- H2: 주요 챕터 (검색 의도를 담은 1차 질문형 소제목) -->
  <section>
    <h2 id="chapter-1">1. E-E-A-T의 4대 핵심 축과 랭킹 반영 원리</h2>

    <!-- 직답 캡슐: 피처드 스니펫 추출 타겟 단락 -->
    <p class="summary-capsule">
      구글 E-E-A-T는 경험(Experience), 전문성(Expertise), 권위도(Authoritativeness), 신뢰성(Trustworthiness)의 4대 지표로 콘텐츠의 신뢰 가치를 평가하는 품질 가이드라인입니다.
    </p>

    <!-- H3: 챕터 내부의 구체적 2차 세부 논점 -->
    <h3 id="section-1-1">1-1. Experience(직접 경험)가 최우선 요소로 부상한 배경</h3>
    <p>실제 제품을 직접 사용해 본 1인칭 후기와 실측 데이터가 필수적입니다...</p>

    <h3 id="section-1-2">1-2. Authoritativeness(권위도)를 입증하는 공인 프로필</h3>
    <p>저자의 링크드인 및 학술 논문 레퍼런스를 연결합니다...</p>
  </section>
</article>
피처드 스니펫 유도를 위한 3대 네이밍 공식
- 정의형 질의 매칭:
H2: 온페이지 SEO란 무엇인가? 정의와 5대 핵심 요소 - 단계별 프로세스 매칭:
H2: 구글 색인 누락을 해결하는 4단계 실전 프로세스 - 비교형 질의 매칭:
H2: 한글 슬러그 vs 영문 슬러그: 장단점 완벽 비교
3. 현업 개발팀과 마케터가 가장 자주 범하는 헤더 태그 4대 오류
가장 빈번한 4대 오류는 1) 사이트 로고에 H1 태그 적용, 2) CSS 폰트 크기 조절을 위해 H태그 남발, 3) 푸터(Footer)나 사이드바 위젯에 H2/H3 사용, 4) 본문 전체를 단 하나의 H2도 없이
<p>태그로만 길게 방치하는 것입니다.
[현업 4대 헤더 태그 실수와 교정 가이드]

1. 로고 이미지에 <h1>을 박아놓은 실수
   - 문제: 모든 하위 페이지의 H1이 "회사 로고"로 통일되어 개별 글의 고유 주제가 증발함.
   - 해결: 로고는 <div> 또는 <span>으로 감싸고, 본문 타이틀에만 고유 <h1> 부여.

2. 시각적 디자인을 위해 H태그를 쓰는 행위
   - 문제: "글자가 커 보여야 하니까 <h2>로 써야지" -> 시맨틱 계층 파괴!
   - 해결: 크기 조절은 CSS class(.text-xl, .font-bold)로 처리하고, H태그는 의미론적으로만 사용.

3. 사이드바와 푸터에 <h3> 태그 남발
   - 문제: "최근 글", "인기 태그", "회사 정보"가 본문과 대등한 <h3>로 인식되어 주제 희석.
   - 해결: 네비게이션과 푸터는 <nav>, <aside>, <p> 태그로 마크업.

4. H태그 없이 3,000자 통짜 글 작성
   - 문제: 구글봇이 글의 논점 단락을 구분하지 못해 긴 글 전체를 저품질 판정.
   - 해결: 500자 단위마다 명확한 H2/H3 소제목으로 단락 분할.
4. 헤더 태그 기반 자동 목차(TOC) 생성과 사용자 체류 시간 증대
본문의 H2 및 H3 헤더에 고유한 영문
id앵커를 부여하고 문서 상단에 인터랙티브 목차(TOC)를 배치하면, 사용자의 본문 탐색 편의성이 높아져 평균 체류 시간이 45% 증가하고 구글 모바일 검색 결과에사이트링크 점프 링크(Sitelinks Jump-to)가 자동 생성됩니다.
// 본문 H2, H3 태그를 자동 수집하여 목차(TOC)를 생성하는 경량 자바스크립트
document.addEventListener('DOMContentLoaded', () => {
  const headers = document.querySelectorAll('article h2, article h3');
  const tocContainer = document.getElementById('table-of-contents');
  if (!tocContainer || headers.length === 0) return;

  const tocList = document.createElement('ul');
  headers.forEach((header, index) => {
    // 헤더에 ID가 없으면 자동 부여
    if (!header.id) {
      header.id = `heading-section-${index + 1}`;
    }

    const listItem = document.createElement('li');
    listItem.className = header.tagName.toLowerCase() === 'h3' ? 'toc-sub-item' : 'toc-main-item';

    const link = document.createElement('a');
    link.href = `#${header.id}`;
    link.textContent = header.textContent.replace(/^H[23]\s*\d*\.?\s*/, ''); // H2/H3 접두사 정돈

    listItem.appendChild(link);
    tocList.appendChild(listItem);
  });

  tocContainer.appendChild(tocList);
});
구글 SERP 사이트링크(Sitelinks) 생성 원리
H2 태그에 <h2 id="core-web-vitals">와 같이 명확한 id가 부여되어 있으면, 구글은 사용자가 특정 질문을 검색했을 때 해당 페이지의 전체가 아니라 그 목차 앵커로 바로 스크롤되는 '해당 섹션으로 바로가기(Jump to)' 링크를 검색 결과에 리치 스니펫으로 제공합니다.
🔗 온페이지 최적화 연계 가이드
- 🏷️ 타이틀 태그 작성법: CTR 2배 상승을 부르는 SEO 타이틀 태그 작성 공식
- 🧠 엔티티 SEO: 키워드 반복을 넘어 개념과 맥락을 증명하는 엔티티 SEO
- ✍️ 콘텐츠 뎁스: 구글 1페이지를 장악하는 콘텐츠 깊이와 토픽 클러스터
데이터 온톨로지 랩 분석 고지:
본 헤더 태그 계층 가이드라인은 W3C HTML5 시맨틱 표준 및 W3C 웹 콘텐츠 접근성 지침(WCAG 2.2)을 100% 준수합니다. 본 저널은 검색 로봇의 기계적 파싱 효율과 시각 장애인의 스크린 리더 탐색 편의성을 모두 만족하는 유니버설 웹 표준을 지향합니다. 기술 자문:lab@theseochronicle.com
- Google Search Central Documentation: Google Search Essentials & Algorithm Systems
- W3C Web Standards & Architecture: W3C HTML5 & Performance Guidelines
- Schema.org Community Standard: Structured Data Vocabularies for News & Articles
- 오피스매거진(Office Magazine): 비즈니스 플랫폼 및 엔터프라이즈 SEO 데이터 아카이브